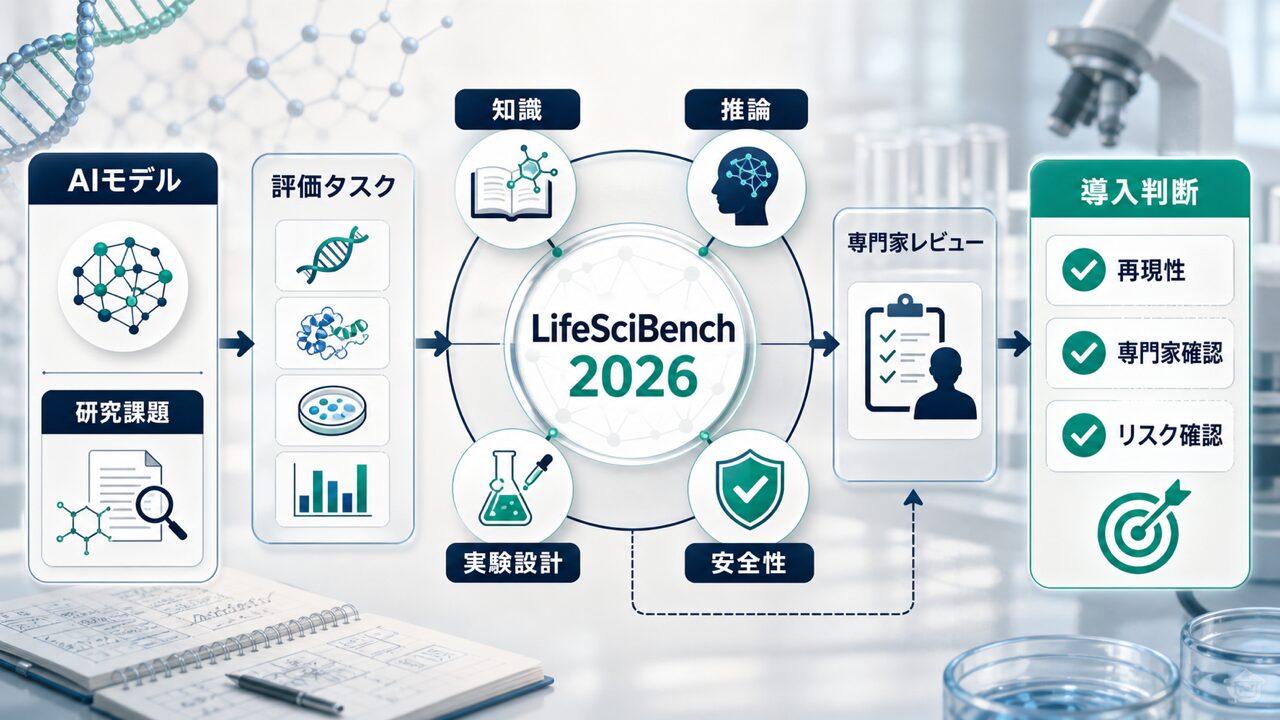
「生成AIは、もう研究者の仕事を手伝えるレベルにあるのか」——この問いに、OpenAIは2026年6月、独自の評価データで答えを出そうとしました。
公開されたのはLifeSciBenchという生命科学特化のベンチマークです。研究者に知識を問うだけでなく、実際の創薬・臨床研究のワークフローをどれだけこなせるかを測る設計になっています。
本記事では、OpenAI公式の発表内容にもとづいて、LifeSciBenchの仕組みと、同時に公開されたライフサイエンス特化モデル「GPT-Rosalind」の評価結果、そして実務での使い所を整理します。
- LifeSciBenchはどんな目的で作られ、何を測っているのか?
- GPT-RosalindはGPT-5.5からどれだけ性能が上がったのか?
- AIがまだ苦手としている生命科学タスクはどこか?
- 研究・製薬の現場でGPT-Rosalindをどう位置づければよいか?
AIは「使い方を設計できた人」が伸びます。
偏差値39から起業した僕でも再現できたので、まずは一つの作業から試してみてください。
この記事でわかること
【完全無料】AI×SNSで成果を出す100大特典を受け取る
AIの使い方を、SNS運用の実務につなげたい方へ。LINEで特典の案内を受け取れます。
- LifeSciBenchの目的と規模(750タスク・7ワークフロー)
- タスク設計とルーブリック採点の仕組み
- GPT-RosalindのLifeSciBenchでの評価結果
- LifeSciBenchで見えたAIの弱点
- 姉妹ベンチマーク(MedChemBench・GeneBench・LabWorkBench)の結果
- 製薬・医療現場での実用イメージ
- GPT-Rosalindの提供状況とアクセス方法
- LifeSciBenchというベンチマーク自体の限界
LifeSciBenchとは?OpenAIが生命科学AI評価に乗り出した背景
LifeSciBenchは、OpenAIが2026年6月17日に公開した、7つのワークフローと7つの生物学領域にまたがる専門家作成の750タスクからなる評価ベンチマークです(LifeSciBench のご紹介)。
既存のベンチマークで測れなかったもの
研究者は、不完全なエビデンスを解釈し、相反する結果を照合し、難しい実験を設計し、アッセイのトラブルシューティングを行い、不確実性の下で次の一手を判断します。OpenAI公式は、こうした現実の研究業務を、単一の知識想起問題や整理された予測問題を中心とする従来の評価では十分に測れていなかったと説明しています(LifeSciBench のご紹介)。
750タスクの規模と作成プロセス
LifeSciBenchのタスクは、バイオテクノロジーまたは製薬業界での経験を持つ博士レベルの科学者173名が作成しました。タスクは採択前の改訂サイクルに回数上限を設けず、採択されたタスクは平均6回の自動レビューサイクルと少なくとも2ラウンドの専門家レビューを経て、関連分野のレビュアー間で90%以上の一致を得たものだけが採用されています(LifeSciBench のご紹介)。ベンチマーク全体では、図・PDF・表・配列ファイル・構造や化学ファイル・Web参照にまたがる1,062件のアーティファクトが使われ、タスクの53%は少なくとも1つのアーティファクトの解釈を求められます。
LifeSciBenchの問題設計と採点方法
LifeSciBenchのタスクは自由記述式の回答で構成され、専門家が作成したタスク固有のルーブリックで採点されます。全体で19,020個の採点基準(タスクあたり平均25個)が用意されています。
自由記述回答とタスク固有ルーブリック
各タスクは、科学的なプロンプトと関連する文脈・アーティファクトを提示し、モデルに自由記述式で回答させる形式です。専門家が作成したルーブリックが、期待される回答に含まれるべき科学的主張・計算・意思決定・根拠を具体的な採点基準に分解し、最終的な結論の正しさだけでなく、そこに至る過程が科学的に妥当かどうかも評価します(LifeSciBench のご紹介)。
結果は2つの指標で報告されます。合格率は、タスクレベルの成功閾値である70%を満たしたタスクの割合、スコアは平均ルーブリック報酬で、タスク全体を解けなくても個別の採点基準ごとに部分点が与えられます(LifeSciBench のご紹介)。
独立レビューによる検証:453名のレビュアー
LifeSciBenchはタスク作成に関与していない453名の独立レビュアーによって検証されました。このうち97%は博士号または同等の学位を持ち、平均12年の分野経験と14件の査読付き論文を持ち、88%が少なくとも1件の受賞またはフェローシップの経験があると回答しています。現実の研究業務との整合性や科学的根拠の有無など複数の観点での評価一致率は、すべてのカテゴリで96%を超えました(LifeSciBench のご紹介)。
GPT-RosalindはLifeSciBenchでGPT-5.5からどれだけ進歩したか
OpenAI公式によれば、GPT-RosalindはGPT-5.5に対して明確な進歩を示し、LifeSciBench全体の厳密合格率を25.7%から36.1%へ引き上げました(LifeSciBench のご紹介)。
GPT-Rosalindというモデルの位置づけ
GPT-Rosalindは、エンタープライズ規模のライフサイエンス研究向けに特化したモデルシリーズです。OpenAIは、GPT-5.5のエージェント型コーディングとツール利用能力に、創薬化学やゲノミクスなど中核的な創薬領域でのモデル知能を組み合わせたと説明しています(GPT-Rosalind の新機能)。汎用の推論モデルとの違いを知りたい場合は、GPT-6世代の汎用モデルとの違いをまとめた記事もあわせて参考にしてください。
科学コミュニケーションとトランスレーションでの伸び
モデル能力の進歩が最も強く表れたのは、科学コミュニケーションとトランスレーションの領域です。科学コミュニケーションの合格率はGPT-5.5の56.3%からGPT-Rosalindの71.1%に上昇しました(このカテゴリはタスク数が9件と少ないため参考値として慎重に解釈すべきとOpenAIは付言しています)。トランスレーション(前臨床エビデンスを臨床的示唆に橋渡しするプロセス)も、GPT-5.5の36.8%からGPT-Rosalindの57.7%に上昇しています(LifeSciBench のご紹介)。
ルーブリックレベルの結果も同じ傾向です。専門家にとって実行可能な出力が求められるタスクでは、GPT-RosalindのスコアはGPT-5.5の29.1%に対して44.7%、不確実性や留意点の扱いが求められるタスクではGPT-5.5の29.3%に対して44.8%でした(LifeSciBench のご紹介)。
LifeSciBenchでAIがまだ苦手とする領域
LifeSciBenchは、設計・最適化・予測や分析のワークフロー、そしてアーティファクトを含むタスクや厳密な出力形式が求められるタスクで、GPT-Rosalindを含むフロンティアモデルの性能がなお大きく低下することを示しています。
設計・最適化・予測とアーティファクトの壁
設計・最適化・予測は依然として最も難しいワークフローの一つで、GPT-Rosalindの合格率は30.7%にとどまります。分析も同様に難しく、30.3%です。アーティファクトの扱いも明確なギャップで、GPT-Rosalindの合格率はテキストのみのタスクの45.1%から、アーティファクトやURLを含むタスクの28.1%へ低下します。GPT-5.5も同じ傾向を示し、29.9%から21.9%へ低下しました。OpenAI公式は、フロンティアモデルが複雑な図や大規模な配列ファイルから情報を抽出し、最終回答に統合することに苦戦していると分析しています(LifeSciBench のご紹介)。
厳密な出力形式が求められるタスクの脆さ
厳密な数値・配列・構造・コンストラクトレベルの出力が求められるタスクでは、合格率がさらに下がります。GPT-Rosalindは数値タスクで14.8%、配列または構造の出力で24.0%、コンストラクト生成タスクで27.3%にとどまり、GPT-5.5からの改善はわずかです。CRISPR/HDRドナー設計やsiRNA設計のように、そのまま使えるほど厳密な出力が必要なワークフローでは、こうした弱さが実務上の意味を持つとOpenAIは指摘しています(LifeSciBench のご紹介)。
一方で、タスクの約14%では、モデルは厳密な合格閾値には届かなくてもルーブリック上で相当な点数を得ています。GPT-Rosalindでは、合格率が20%未満でも少なくとも50%のルーブリック報酬を得たタスクが109件ありました。部分的に有用な回答を生成できているケースは少なくないということです(LifeSciBench のご紹介)。
LifeSciBenchの評価結果:主要モデル比較テーブル
ここまでの結果を、OpenAI公式が公開した数値でまとめると次のとおりです(LifeSciBench のご紹介)。GPT-5.5の列が「非公開」の項目は、公式発表でGPT-Rosalindの数値だけが示されているものです。
| 評価軸 | GPT-5.5 | GPT-Rosalind |
|---|---|---|
| 全体の厳密合格率 | 25.7% | 36.1% |
| 科学コミュニケーション合格率(参考値・n=9) | 56.3% | 71.1% |
| トランスレーション合格率 | 36.8% | 57.7% |
| 実行可能な出力が必要なタスクのルーブリックスコア | 29.1% | 44.7% |
| 不確実性・留意点の扱いが必要なタスクのルーブリックスコア | 29.3% | 44.8% |
| 設計・最適化・予測タスク合格率 | 非公開 | 30.7% |
| 分析タスク合格率 | 非公開 | 30.3% |
| テキストのみタスク合格率 | 29.9% | 45.1% |
| アーティファクトを含むタスク合格率 | 21.9% | 28.1% |
なお、OpenAI公式のLifeSciBench紹介ページは評価カテゴリを7つのワークフロー(トランスレーションと科学コミュニケーションを別々に集計)として説明する一方、GPT-Rosalindの機能紹介ページでは同じ枠組みを6つのワークフロー領域(翻訳とコミュニケーションを1カテゴリとして集計)と説明しており、カテゴリの数え方が発表元記事によって異なります。本記事では数値が明記されている前者の区分に沿って表記しています(LifeSciBench のご紹介 / GPT-Rosalind の新機能)。
姉妹ベンチマークで見るGPT-Rosalindの強み:創薬化学・ゲノミクス・ラボ支援
OpenAIはLifeSciBenchとあわせて、創薬化学のMedChemBench、ゲノミクス・定量生物学のGeneBench、実験室業務のLabWorkBenchという3つの評価でも、GPT-RosalindがGPT-5.5を上回ったと発表しています。
MedChemBench:創薬化学でのマルチモーダル推論
MedChemBenchは、化学構造の理解、構造活性相関(SAR)、薬効・毒性・ADMEの予測、多パラメータのリード最適化、逆合成など、現実的な創薬化学ワークフローを反映して設計された評価です。GPT-RosalindはMedChemBenchでGPT-5.5の25.1%に対して27.5%を記録し、使用トークンは7.2%少なくなっています(GPT-Rosalind の新機能)。
GeneBench:ゲノミクス・定量生物学のエージェント型分析
GeneBenchは、機能ゲノミクス・空間トランスクリプトミクス・プロテオミクス・エピゲノミクス・応用遺伝学など、長期的な定量タスクでのエージェント型性能を評価します。GPT-RosalindはGPT-5.5より31%少ないトークンで、21.6%対20.4%という高い精度を達成しました(GPT-Rosalind の新機能)。
LabWorkBench:実験室プロトコルのトラブルシューティング支援
LabWorkBenchは、科学者が実際に使うウェットラボプロトコルにおいて、摂動を実験結果に結び付けるモデルの能力を評価します。使用データは専有データのため汚染リスクが低いとされ、GPT-RosalindはGPT-5.5の55.8%に対して63.2%を記録し、使用トークンは5.3%少なくなっています(GPT-Rosalind の新機能)。こうした実行レイヤーは、OpenAIが構築したLife Sciences ResearchとLife Sciences NGS Analysisという2つのプラグインを通じて動かす設計で、すべてのユーザーがCodex経由でアクセスできます。企業でのCodex導入を検討している場合は、Codexの企業導入で押さえておきたいポイントをまとめた記事も参考にしてください。
| ベンチマーク | 対象領域 | GPT-5.5 | GPT-Rosalind | トークン使用量 |
|---|---|---|---|---|
| MedChemBench | 創薬化学(SAR・ADME予測・逆合成等) | 25.1% | 27.5% | 7.2%少ない |
| GeneBench | ゲノミクス・定量生物学のエージェント型分析 | 20.4% | 21.6% | 31%少ない |
| LabWorkBench | ウェットラボプロトコルのトラブルシューティング | 55.8% | 63.2% | 5.3%少ない |
製薬・創薬・医療現場への実用示唆
GPT-Rosalindは、エビデンスの査読支援や研究データの統合など、専門家の一次判断を代替せず補助する形での実務利用を前提に設計されています。
創薬エビデンスの査読支援という具体例
具体例として、OpenAI公式が公開した評価タスクの一つに、FDAとのType Bミーティングを想定し、AAV9を使ったマイクロジストロフィン遺伝子治療のエビデンスパッケージ(ウェスタンブロット定量・免疫蛍光・NSAA機能評価・安全性データなど)を項目ごとに査読させ、代替エンドポイントとしての妥当性を批判的に検討させるものがあります。模範解答は、アッセイの特異性、対照群設計、年齢による交絡、持続性データの不足など、審査官が指摘しうる弱点を具体的に列挙する内容でした(GPT-Rosalind の新機能)。こうしたタスクは、専門家によるエビデンス査読の下準備としてAIをどう位置づけられるかを示しています。
Novo Nordiskとの提携:研究データ統合への実装
GPT-Rosalindは現在、信頼できる組織に限定して提供する導入モデルを通じ、世界中の対象組織に研究プレビューとして提供されています。展開の一環として、OpenAIは製薬会社Novo Nordiskの医学研究を支える提携を発表しました。OpenAI公式は、GPT-Rosalindのより強い生物学的理解が文献・ゲノミクス・トランスクリプトミクス・配列・構造・実験結果をまたいでエビデンスを結び付ける支援になるとしており、同社のR&D部門でAI・デジタルイノベーションを統括するMishal Patel氏も、OpenAIとの提携が創薬へのより厳密で実践的なアプローチにどう役立つか探ることへの期待を示しています(GPT-Rosalind の新機能)。推論モデルが実際に診断支援へ使われた事例としては、小児の希少疾患の診断を推論モデルが後押しした事例を紹介した記事もあわせて参考になります。
医療現場での利用上の注意
LifeSciBenchの結果が示すとおり、GPT-Rosalindはアーティファクトを含むタスクや厳密な出力が求められるタスクでまだ弱さを抱えています。診断・処方・治療方針など患者に直接影響する判断にAIの出力をそのまま用いることは想定されておらず、専門家によるレビューを前提とした研究・教育・下準備の用途にとどめる必要があります。
GPT-Rosalindの提供状況とアクセス方法
GPT-Rosalindは公開APIの一般提供ではなく、信頼できる組織に限定して提供する導入モデルを通じた研究プレビューとして、対象組織にアクセスが拡大されている段階です。
対象となる組織の条件
OpenAI公式は、明確な公益性を持つ正当な科学研究を実施し、強力なガバナンスと安全監督を備え、エンタープライズ級のセキュリティでアクセスを管理している組織を対象にすると説明しています。Enterpriseアカウントを持たない対象組織向けには、OpenAI管理のワークスペースの提供も始まっています(GPT-Rosalind の新機能)。アカウント側の利用状況を管理する機能については、ChatGPT Enterpriseの利用管理機能を取り上げた記事も参考になります。なお、本記事の執筆時点で、GPT-Rosalindの利用料金(トークン単価等)は公式ページで公開されていません。
研究プレビューという位置づけ
GPT-Rosalindはまだ研究プレビュー段階のモデルであり、OpenAIは今後もモデルの生物学的推論を改善し、ツールを多用する長期的な研究ワークフローへの対応を広げていくとしています(GPT-Rosalind の新機能)。OpenAIは他のモデルでも提供終了・切り替えを計画的に進めており、OpenAIのモデル非推奨化の進め方を解説した記事のとおり、研究プレビューの仕様も今後変わっていく前提で利用計画を立てる必要があります。OpenAI APIの利用コストを抑える一般的な手段としては非同期処理の仕組みもあり、OpenAI Batch APIの仕組みと料金を解説した記事が参考になります。
LifeSciBenchの限界と注意点
OpenAI公式は、LifeSciBenchでの高い性能を下流の研究インパクトの直接的な尺度と解釈すべきではなく、現実的なタスクレベルの能力を示すエビデンスとして扱うべきだと説明しています。
ベンチマークスコアの解釈上の注意
LifeSciBenchは反復的に現れる業界ワークフローを反映した自己完結型タスクに焦点を当てていますが、多くの科学専門分野やタスクタイプは対象範囲外です。実際の研究は反復的で、科学者は新たなエビデンスを集め、仮説を見直し、追試実験を設計し、結果が出るたびに計画を適応させます。LifeSciBenchのタスクは、こうした反復のごく一部を切り取ったものにすぎません(LifeSciBench のご紹介)。
今後の展望:公益分野への展開
OpenAIは、創薬やトランスレーショナル医療にとどまらず、公衆衛生や公衆衛生上の備え、バイオディフェンスといった公益性の高い分野にもライフサイエンスAIを適用する方針を示しており、「Rosalind Biodefense」という取り組みも予告しています。ベンチマーク性能を実際の研究ワークフローへの導入研究に結び付けることが、次のステップと位置づけられています(GPT-Rosalind の新機能)。
よくある質問(FAQ)
- Q1. LifeSciBenchはどこで公開されていますか?
- OpenAI公式サイトで2026年6月17日に公開された記事「LifeSciBench のご紹介」で概要が説明されています。同記事内には論文へのリンクも用意されています。
- Q2. GPT-Rosalindは今すぐ誰でも使えますか?
- いいえ。GPT-Rosalindは、信頼できる組織に限定して提供する導入モデルを通じた研究プレビューとして、対象組織にのみ提供されています。Enterpriseアカウントを持たない対象組織向けにはOpenAI管理のワークスペースも用意されていますが、一般公開のAPIやChatGPTのプランとは提供形態が異なります(GPT-Rosalind の新機能)。
- Q3. GPT-RosalindはLifeSciBenchでGPT-5.5からどれだけ改善しましたか?
- 全体の厳密合格率がGPT-5.5の25.7%からGPT-Rosalindの36.1%に上昇しました。特に科学コミュニケーション(56.3%→71.1%、参考値)とトランスレーション(36.8%→57.7%)での伸びが大きく、一方で設計・最適化・予測(30.7%)や分析(30.3%)は引き続き低い水準です(LifeSciBench のご紹介)。
- Q4. LifeSciBenchの採点はどのように行われますか?
- 自由記述式の回答をタスク固有のルーブリックで採点します。全体で19,020個の採点基準(タスクあたり平均25個)が使われ、タスクレベルの成功閾値(70%)を満たしたかどうかを示す合格率と、部分点を含む平均ルーブリック報酬であるスコアの2指標が報告されます(LifeSciBench のご紹介)。
- Q5. LifeSciBenchはどんな分野を評価対象にしていますか?
- エビデンス処理・分析・設計と最適化・科学的推論・検証と運用・トランスレーション・科学コミュニケーションという7つのワークフローと、7つの生物学領域を横断する750タスクで構成されています。具体的な生物学領域の内訳は公式ページで個別に列挙されていません。
- Q6. GPT-RosalindはMedChemBench・GeneBench・LabWorkBenchでどう改善しましたか?
- MedChemBenchでGPT-5.5の25.1%に対して27.5%、GeneBenchで20.4%に対して21.6%、LabWorkBenchで55.8%に対して63.2%を記録し、いずれも使用トークン数はGPT-5.5より少なくなっています(GPT-Rosalind の新機能)。
- Q7. LifeSciBenchの評価でAIが苦手とする領域はありますか?
- はい。設計・最適化・予測(合格率30.7%)や分析(30.3%)、アーティファクトを含むタスク(28.1%)、数値・配列・構造・コンストラクトなど厳密な出力形式が求められるタスク(14.8〜27.3%)で、GPT-Rosalindを含むフロンティアモデルの性能はまだ低い水準にとどまっています(LifeSciBench のご紹介)。
- Q8. LifeSciBenchのスコアは実際の研究成果を保証しますか?
- いいえ。OpenAI公式は、LifeSciBenchでの高い性能は下流の研究インパクトを直接示す尺度ではなく、現実的なタスクレベルの能力を示すエビデンスとして解釈すべきだと説明しています。実際の研究は反復的であり、ベンチマークはその一部しか捉えていません(LifeSciBench のご紹介)。
生命科学AI用語集
LifeSciBenchとGPT-Rosalindの理解に欠かせない基本用語を、ベンチマーク・採点・関連モデルの3系統に整理しました(LifeSciBench のご紹介)。
| 用語 | 説明 |
|---|---|
| LifeSciBench | OpenAIが2026年6月に公開した生命科学分野のAI評価ベンチマーク。7ワークフロー×7生物学領域にまたがる750タスクで構成される |
| GPT-Rosalind | エンタープライズ規模のライフサイエンス研究向けにOpenAIが提供するモデルシリーズ。信頼できる組織に限定して提供する導入モデルを通じた研究プレビュー段階 |
| ルーブリック採点 | 期待される回答を具体的な科学的主張・計算・根拠などに分解した採点基準。LifeSciBenchでは全体で19,020個の基準が使われる |
| 合格率とスコア | LifeSciBenchが報告する2つの指標。合格率はタスクレベルの成功閾値(70%)を満たした割合、スコアは部分点を含む平均ルーブリック報酬 |
| MedChemBench | 創薬化学のワークフローを反映したOpenAIの評価。構造活性相関やADME予測などを対象とする |
| GeneBench | ゲノミクス・定量生物学の長期的なエージェント型分析を評価するOpenAIのベンチマーク |
| LabWorkBench | 実際のウェットラボプロトコルでのトラブルシューティング能力を評価するOpenAIのベンチマーク |
| 信頼できる組織に限定して提供する導入モデル | GPT-Rosalindのアクセス方式。強いガバナンスと安全監督を備えた対象組織にのみ研究プレビューとして提供される |
まとめ:LifeSciBenchが示すAIと生命科学研究の現在地
LifeSciBenchは、OpenAIが現役の科学者173名と453名の独立レビュアーを巻き込んで設計した、生命科学研究の現実的なワークフローを測るベンチマークです。ライフサイエンス特化モデルGPT-Rosalindは、GPT-5.5と比べて全体の厳密合格率を25.7%から36.1%に引き上げ、特に科学コミュニケーションとトランスレーションで大きく伸びました(LifeSciBench のご紹介)。
一方で、設計・最適化・予測やアーティファクトを含むタスク、厳密な出力形式が必要なタスクでは、まだ合格率が3割前後にとどまっています。OpenAI自身も、LifeSciBenchのスコアは下流の研究インパクトを直接保証するものではないと位置づけています。GPT-Rosalindは現在、信頼できる組織に限定して提供する導入モデルを通じた研究プレビュー段階にあり、Novo Nordiskのような製薬会社との提携を通じて実世界での有効性が検証されている途中です。
生命科学・医療分野での重要な判断は、専門家によるレビューを経る前提で、こうした評価結果を参考情報として活用することが実務では現実的です。
AI×SNSで「普通の人」が成果を出す方法を、無料で体系的に学べます
ChatGPTやAIツールをビジネス・SNS発信に活かしたい方へ。
岡田颯太が実践してきたAI活用ノウハウを、すぐに使える特典として無料でお届けしています。
LifeSciBenchのようなAIの評価データを参考にしながら、あなたの発信や業務にAIを取り入れる第一歩を踏み出しましょう。
※本記事は2026年6月時点でOpenAI公式が公開した情報にもとづいています。
モデルの提供状況・評価結果は変更される場合があります。
最新情報はOpenAI公式でご確認ください。
次に読みたい関連記事
このテーマの全体像: ChatGPTの使い方の完全ガイド
あわせて読みたい・姉妹メディア