「ChatGPTって、会話を保存してるの? それとも毎回忘れてるの?」——この質問に自信を持って答えられるだろうか。
ネット上では「Dreaming V3」という名前のChatGPT記憶システムが話題になることがある。
だが実際に調べてみると、この名称はOpenAIの公式ドキュメントのどこにも見当たらない。
本記事では、噂ベースの機能名に頼るのではなく、OpenAI公式ドキュメントで実際に確認できる「会話状態(Conversation State)」の仕組みを、API開発者にもChatGPTユーザーにも分かる形で整理する。
- 「Dreaming V3」は本当に存在するの? 公式ではどう説明されているの?
- ChatGPTやOpenAI APIは会話をどうやって「覚えている」の?
- 会話データはOpenAIのモデル学習に使われるの?
- previous_response_idとConversationsオブジェクト、どちらを使えばいいの?
AIは「使い方を設計できた人」が伸びます。
偏差値39から起業した僕でも再現できたので、まずは一つの作業から試してみてください。
この記事でわかること
【完全無料】AI×SNSで成果を出す100大特典を受け取る
AIの使い方を、SNS運用の実務につなげたい方へ。LINEで特典の案内を受け取れます。
- 「Dreaming V3」という名称が公式ドキュメントで確認できるかどうか
- ChatGPTの会話が「続いている」ように見える本当の仕組み
- OpenAI APIで会話状態を管理する3つの方法
- 3つの方法の違いと使い分け
- storeパラメータとレスポンスの保持期間ルール
- 会話データがモデルの学習に使われるかどうかの公式見解
- WebSocketモードでの会話継続の仕組み
- 実務での活用シーンと設計時の注意点
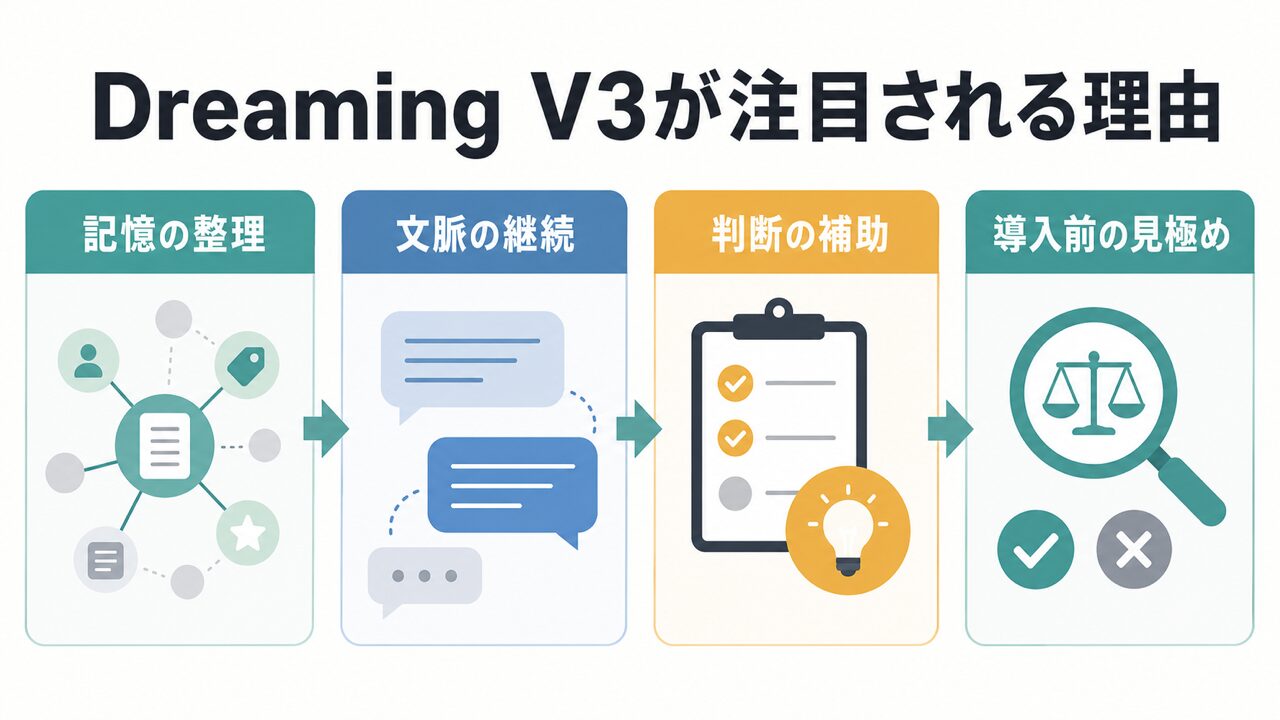
ChatGPT記憶システム「Dreaming V3」が注目される理由
SNSや一部のまとめ記事で「Dreaming V3」という呼び方を見かけることがあるが、2026年9月時点でOpenAIの公式ドキュメント(developers.openai.com)にこの名称は見当たらない。断定的な製品名として扱うのは避け、本記事では公式ドキュメントに実在する「会話状態(Conversation State)」の仕組みを中心に解説する。
なぜ非公式の名称が広まってしまうのか
AI関連の新機能は開発が速く、開発者コミュニティや個人ブログが独自にニックネームを付けて拡散することがある。
「Dreaming」という言葉自体は、人間の睡眠中の記憶整理になぞらえた比喩として語られやすく、話題性のあるラベルになりやすい。
ただし、比喻がどれだけ魅力的でも、公式ドキュメントに記載がない名称を製品仕様として紹介すると、読者が実際にChatGPTの設定画面やOpenAIのAPIリファレンスを調べたときに情報がかみ合わなくなる。
そこで本記事では、名称の真偽そのものより「実際に何が確認できるか」を軸に構成し直した。
ChatGPTの基本的な使い方から会話の仕組みを見直したい場合は、ChatGPTの使い方ガイドもあわせて参考にしてほしい。
ChatGPTが「会話を覚えている」ように感じる本当の理由
ChatGPTとの会話が「続いている」ように感じるのは、単一の神秘的な機能によるものではなく、OpenAIが提供する複数の会話状態管理の仕組みが組み合わさって成立している。
その土台になっているのが、OpenAI公式ドキュメント「Conversation state」で説明されている会話管理の考え方だ。
OpenAIの公式ガイドは、テキスト生成のリクエストは本来1回ごとに独立した「ステートレス」なものであり、複数ターンの会話を成立させるには、こちらから明示的に過去のやり取りを渡す必要があると説明している。
つまり「ChatGPTが記憶している」ように見える体験は、裏側でOpenAIのAPI基盤が会話履歴をうまく引き継ぐ設計になっているために生まれている(OpenAI公式:Conversation state)。
OpenAI APIで会話状態を管理する3つの方法
OpenAIの公式ドキュメントでは、会話状態を管理する方法として「手動で会話履歴を渡す」「previous_response_idで応答をチェーンする」「Conversationsオブジェクトで永続化する」の3つが紹介されている。
それぞれ保持される期間や適した用途が異なるため、目的に合わせて選ぶ必要がある。
小さな検証段階では手動管理やprevious_response_idから始め、複数人・複数端末で会話を扱う本番運用に進む段階でConversationsオブジェクトへ切り替える、という段階的な選び方も現実的だ。
方法1:会話履歴を毎回渡す「手動管理」
もっとも基本的な方法は、userとassistantのメッセージを交互に並べた配列をリクエストのたびに渡すやり方だ。
公式ドキュメントのサンプルでは、以下のように過去のやり取りをinputに含めることで、モデルに文脈を引き継がせている。
const response = await openai.responses.create({
  model: "gpt-6-astra",
  input: [
    { role: "user", content: "knock knock." },
    { role: "assistant", content: "Who's there?" },
    { role: "user", content: "Orange." },
  ],
});
推論モデルを使う場合は、応答のoutput配列に含まれる推論アイテムも含めて次のリクエストへそのまま渡すことが推奨されている。
Responses APIは既定で暗号化された推論アイテムを返し、これをそのまま次のリクエストに含めることで、応答の一貫性を保つ「phase」情報が維持される。
入出力の型を厳密にそろえたい場合は、構造化出力の使い方ガイドも参考になる。
方法2:previous_response_idで応答をチェーンする
2つ目は、直前の応答のIDを次のリクエストに渡して会話をつなげる方法だ。
この方法では会話履歴を自分で組み立て直す必要がなく、レスポンスの参照だけで文脈を引き継げる。
response = client.responses.create(
    model="gpt-6-astra",
    input="tell me a joke",
)
second_response = client.responses.create(
    model="gpt-6-astra",
    previous_response_id=response.id,
    input=[{"role": "user", "content": "explain why this is funny."}],
)ツール呼び出しの結果を会話に含めて引き継ぎたい場合は、Function callingの使い方ガイドで設計手順を確認しておくと理解しやすい。
なお、公式ドキュメントのサンプルコードでは、この記事の執筆時点でモデル名に「gpt-6-astra」が使われている。
モデルの立ち位置はGPT-6 Astraとはで解説している。
方法3:Conversationsオブジェクトで会話を永続化する
3つ目は、Conversations APIで会話そのものをオブジェクトとして作成し、セッションや端末をまたいで使い続ける方法だ。
公式ドキュメントは、Conversationsオブジェクトが「メッセージ、ツール呼び出し、ツールの出力、その他のデータ」をアイテムとして保存すると説明している。
const conversation = await client.conversations.create();
const response = await client.responses.create({
  model: "gpt-6-astra",
  input: [{ role: "user", content: "What are the five Ds of dodgeball?" }],
  conversation: conversation.id,
});
エージェント型のツールやCodexのように、複数ステップにまたがる処理を継続させたい場合にも、この永続化の考え方が土台になる。
Codexの提供形態ごとの違いはOpenAI Codexの提供形態の違いで整理している。
3つの方法を比較する
3つの会話状態管理の方法は、保持期間・適した場面・注意点がそれぞれ異なる。
次の表は、OpenAI公式ドキュメントの記載内容にもとづいて特徴を整理したものだ。
| 方法 | 概要 | 保持期間の考え方 | 適した場面 |
|---|---|---|---|
| 手動で会話履歴を渡す | messages配列を毎回組み立てて送信する | アプリ側で管理(OpenAI側の既定保存には依存しない) | 会話ログを自社で完全にコントロールしたい場合 |
| previous_response_id | 直前のレスポンスIDを渡してチェーンする | store:trueなら既定30日、store:falseなら保存されない | シンプルな1本のスレッドを継続したい場合 |
| Conversationsオブジェクト | 会話をオブジェクトとして作成し継続参照する | 削除するまで保持(30日のTTLの対象外) | セッションや端末をまたいで長期的に使う場合 |
チェーンが長くなるほど、それまでの入力トークンもまとめて課金対象になる点は、公式ドキュメントでも明記されている。
料金プランの全体像はChatGPT料金プラン完全比較を参照してほしい。
storeパラメータとレスポンスの保持期間ルール
Responses APIやChat Completions APIでは、storeパラメータの設定によってレスポンスの保存挙動が変わる。
OpenAI公式ドキュメントの「Data controls in the OpenAI platform」によると、エンドポイントごとに保持のルールが明確に定められている。
| エンドポイント | モデル学習への利用 | アプリケーション状態の保持期間 | Zero Data Retention対象 |
|---|---|---|---|
| /v1/responses | 利用されない | 既定30日(storeをfalseにすると保存されない) | 対象(条件あり) |
| /v1/chat/completions | 利用されない | 既定30日(storeをfalseにすると保存されない) | 対象(条件あり) |
| /v1/conversations・/v1/conversations/items | 利用されない | 削除するまで保持(30日のTTLの対象外) | 対象外 |
Zero Data Retentionが承認された組織では、リクエストでstoreをtrueに指定しても、実際には常にfalseとして扱われるとされている。
非同期でまとめて処理するBatch APIなど、他のエンドポイントでも保持の考え方は共通している部分がある。
詳しくはOpenAI Batch APIの使い方を参照してほしい。
会話データはモデルの学習に使われるのか
OpenAI公式の「Data controls in the OpenAI platform」ガイドは、「2023年3月1日以降、OpenAI APIに送信されたデータは、明示的にオプトインしない限りモデルの学習・改善には使われない」と明記している。
これはAPI経由のデータに関する公式見解であり、法人利用を検討する際の判断材料になる。
企業が業務でOpenAIのAPIやChatGPTを使う場合、悪用監視ログの保持期間や、Zero Data Retention・Modified Abuse Monitoringといった追加の管理オプションが用意されている。
これらは審査を経て組織単位・プロジェクト単位で設定するものであり、標準設定のまま使う場合との違いを理解しておく必要がある(OpenAI公式:Data controls in the OpenAI platform)。
WebSocketモードでの会話継続の仕組み
Responses APIにはWebSocketモードも用意されており、この場合もprevious_response_idと同じ考え方で会話を継続できる。
公式ドキュメントによると、接続単位のキャッシュが直近のレスポンスを保持しており、stream_idを使うと複数の処理系統(レーン)ごとに最新の応答を保持できる。
キャッシュされていないIDを参照しようとした場合は、previous_response_idをnullにした新しいターンとして、必要な文脈をあらためて渡す必要があるとされている。
リアルタイム性の高いやり取りを設計する際は、この挙動を前提にエラー処理を組んでおくと安全だ。
実務での活用シーン:コンテンツ制作・営業・カスタマーサポート
会話状態の管理を正しく設計すると、毎回同じ前提を説明し直す手間が減り、業務での再現性が高まる。
以下は仕組みの理解を助けるための仮の例であり、実際の効果は用途や運用体制によって異なる。
たとえばコンテンツ制作の現場では、previous_response_idで会話をチェーンしながら「トーン」「NGワード」といった前提を引き継ぎ、毎回の指示を短くする使い方が考えられる。
文章作成やメール作成の具体的な指示の出し方はChatGPTで文章作成・メール作成はどう使う?で解説している。
営業やカスタマーサポートのように、複数の担当者が同じ会話の続きを扱う場面では、Conversationsオブジェクトで会話をオブジェクトとして永続化し、セッションや端末をまたいで参照する設計が向いている。
業務効率化の観点はChatGPTを仕事で活用して業務効率化するにはにまとめている。
私自身(岡田颯太、株式会社S.Line代表)は偏差値39から起業した経験から、「再現性のある仕組みを作ること」に一貫してこだわってきた。
会話状態の管理も同じ発想で、どの方法を使うかを最初に設計しておけば、担当者が変わっても同じ前提で会話を引き継げる構造になる。
そこに実務上の価値があると感じている。
会話状態を設計するときに誤解しやすい注意点
会話状態の仕組みは便利だが、「会話は自動的にすべて保存される」という思い込みで設計すると、想定外の挙動につながることがある。
特にstoreパラメータの既定値と、Conversationsオブジェクトの保持ルールの違いは混同されやすい。
また、previous_response_idでチェーンを重ねるほど、過去の入力トークンもまとめて課金対象になる点は見落とされがちだ。
会話が長くなるワークフローでは、どこかで要約を挟んで文脈を圧縮するなど、コストと文脈保持のバランスを設計段階で考えておく必要がある。
ChatGPTアプリ側で用途ごとに会話を整理したい場合は、ChatGPTのプロジェクト機能の使い方も参考になる。
推論モデルを使った会話では、応答のoutput配列に含まれる暗号化された推論アイテムを省略して要約だけを次のリクエストに渡してしまうと、応答の一貫性を保つ「phase」情報が失われ、意図と違う結果につながることがある。
出力アイテムはそのまま履歴に追加し、モデル側の判断材料を欠けさせない設計にしておくことが、公式ドキュメントでも案内されている考え方だ。
用語集
本記事で扱った用語を、OpenAI公式ドキュメントの説明にもとづいて整理する。
| 用語 | 説明 |
|---|---|
| 会話状態(Conversation state) | 複数のメッセージ・ターンにまたがって情報を維持するための仕組み全般。OpenAI公式ドキュメントで定義されている用語。 |
| previous_response_id | 直前のレスポンスのIDを次のリクエストに渡し、応答をチェーンして会話を継続するためのパラメータ。 |
| Conversationsオブジェクト | 会話をメッセージ・ツール呼び出し・ツール出力などのアイテムとともに長期保存するためのAPIオブジェクト。 |
| storeパラメータ | レスポンスをOpenAI側に保存するかどうかを指定するパラメータ。falseにすると既定の30日保存が行われない。 |
| Zero Data Retention | 承認された組織向けに、顧客データを悪用監視ログから除外し、storeを常にfalse扱いにする管理オプション。 |
| 暗号化された推論アイテム | Responses APIが既定で返す、推論モデルの内部処理に関する暗号化データ。次のリクエストに含めることで一貫性が保たれる。 |
よくある質問(FAQ)
- Q1. 「Dreaming V3」というChatGPTの記憶システムは公式に存在しますか?
-
2026年9月時点で確認した範囲では、OpenAIの公式ドキュメントにこの名称は見当たらない。
公式に確認できるのは、本記事で解説した「会話状態(Conversation state)」の仕組みであり、名称についての新しい公式発表があれば、その時点の一次情報を確認してほしい。
- Q2. previous_response_idとConversationsオブジェクトはどちらを使えばいいですか?
-
1本のシンプルなスレッドを継続するだけならprevious_response_idで十分な場合が多い。
複数のセッションや端末、複数の担当者にまたがって会話を参照し続けたい場合は、Conversationsオブジェクトの方が公式ドキュメントの想定する用途に近い。
- Q3. storeをfalseにすると何が変わりますか?
-
storeをfalseに設定すると、そのレスポンスは既定の30日保存の対象にならない。
ダッシュボードのログ画面から後で参照する必要がない用途では、falseにしておく設計が公式ドキュメントでも案内されている。
- Q4. 会話データはOpenAIのモデル学習に使われますか?
-
OpenAI公式の説明によると、2023年3月1日以降、APIに送信されたデータは、明示的にオプトインしない限りモデルの学習には使われないとされている。
最新の条件は公式ドキュメントで確認してほしい。
- Q5. previous_response_idで会話をチェーンすると料金はどうなりますか?
-
公式ドキュメントによると、previous_response_idを使ってチェーンした場合でも、それまでのやり取りに含まれる入力トークンはすべて課金対象として計算される。
会話が長くなるほど1回あたりの入力トークン量が増えていく点は把握しておく必要がある。
- Q6. WebSocketモードでも同じ会話状態の仕組みが使えますか?
-
使える。
公式ドキュメントによると、WebSocketモードでもprevious_response_idと同じ考え方で会話を継続でき、stream_idを使うことで処理系統ごとに最新のレスポンスを保持できるとされている。
- Q7. Zero Data Retentionはどんな組織でも使えますか?
-
いいえ。
公式ドキュメントによると、Zero Data RetentionやModified Abuse Monitoringは事前の承認と追加要件への同意が必要な管理オプションであり、標準設定のまま誰でも有効化できるわけではない。
利用を検討する場合は、OpenAIの営業窓口を通じて条件を確認する流れになる。
まとめ
「Dreaming V3」という名称は、2026年9月時点でOpenAIの公式ドキュメントに見当たらず、事実として扱うことはできない。
一方で、ChatGPTやOpenAI APIが会話の文脈を引き継ぐ仕組み自体は、公式ドキュメントに明確に記載されている。
本記事で整理した主なポイントは次の通りだ。
- 会話状態の管理には「手動で履歴を渡す」「previous_response_idでチェーンする」「Conversationsオブジェクトで永続化する」の3つの方法がある
- それぞれ保持期間と適した場面が異なり、目的に合わせて選ぶ必要がある
- storeパラメータの設定によって、レスポンスの既定30日保存の扱いが変わる
- Conversationsオブジェクトの中身は、削除するまで保持される点が他の方法と異なる
- APIに送信したデータは、明示的な同意なしにモデルの学習には使われないと公式に説明されている
- previous_response_idでのチェーンは、過去の入力トークンも含めて課金対象になる
会話状態の仕組みは、名称の話題性よりも「どの方法を選び、どこまで保持するか」を自分の用途に合わせて設計することが本質だ。
まずは今扱っている会話が、どの保持ルールの上に成り立っているのかを確認するところから始めてみてほしい。
AI×SNSで「普通の人」が成果を出す方法を、無料で体系的に学べます
ChatGPTとの会話をどう設計して引き継ぐかという考え方は、SNS運用の情報整理や発信の一貫性づくりにも応用できる。
その具体的な実践ノウハウを100大特典として無料でお届けしている。
※本記事は2026年9月時点でOpenAI公式ドキュメントから確認できた情報をもとにしています。
仕様は変更される場合があるため、最新情報はOpenAI公式でご確認ください。
あわせて読みたい・姉妹メディア