OpenAIは2026年6月18日、小児の希少遺伝性疾患をめぐる研究を公開しました。Boston Children’s HospitalのManton Center for Orphan Disease Research、Harvard University、OpenAIの研究者が、過去に解析されながら未解決だった376症例を、OpenAI o3 Deep Researchというリーズニングモデルで再解析し、専門家の確認を経て18症例で診断が確定した、という内容です(出典:OpenAI公式発表(2026年6月18日))。
「18件の新診断」という数字だけが一人歩きすると、「AIが病気を見抜く時代が来た」と受け取られがちです。しかし公式発表は、モデルが患者を診断したわけではなく、診断はすべて医師などの資格を持つ専門家が確立された手順で行ったと明記しています。この記事では、18という数字が何を数えたものか、モデルと人間がそれぞれ何を担ったのか、そして何がまだ分かっていないのかを、公式発表で確認できた範囲だけで整理します。
- 「18件」は何を数えた数字なのか
- モデルは何をして、人間は何を確かめたのか
- 診断率4.8%はどう読めばよいのか
- 患者・家族、医療者、AI活用を考える人は、この結果をどう受け止めるべきか
医療に関する話題は、公式発表に書かれている範囲で読むことが大切です。この記事も、OpenAIの発表で確認できた内容だけをまとめています。
この研究とは? OpenAI o3 Deep Researchというリーズニングモデルを使い、過去に解析されても原因が分からなかった小児の376症例を再解析した研究です。モデルが根拠つきの候補説明を示し、専門家のレビュー・追加検査・臨床的確認を経て、医師が18症例で診断を確定しました(OpenAI公式発表)。モデルが診断したのではなく、専門家が確かめる手がかりを出した研究です。
この記事でわかること
【完全無料】AI×SNSで成果を出す100大特典を受け取る
AIの使い方を、SNS運用の実務につなげたい方へ。LINEで特典の案内を受け取れます。
- OpenAI推論モデルが18件の新診断を支援:何が起きたのか
- 研究の進め方:モデルに何を渡し、誰が確かめたか
- 結果:376症例のうち18症例で診断を確定
- 公式発表が挙げた具体例
- なぜ古い症例に新しい答えが見つかるのか
- モデルと人間の役割分担
- 公式発表が示す限界
- 読者別の受け止め方と今後の研究
OpenAI推論モデルが18件の新診断を支援:何が起きたのか
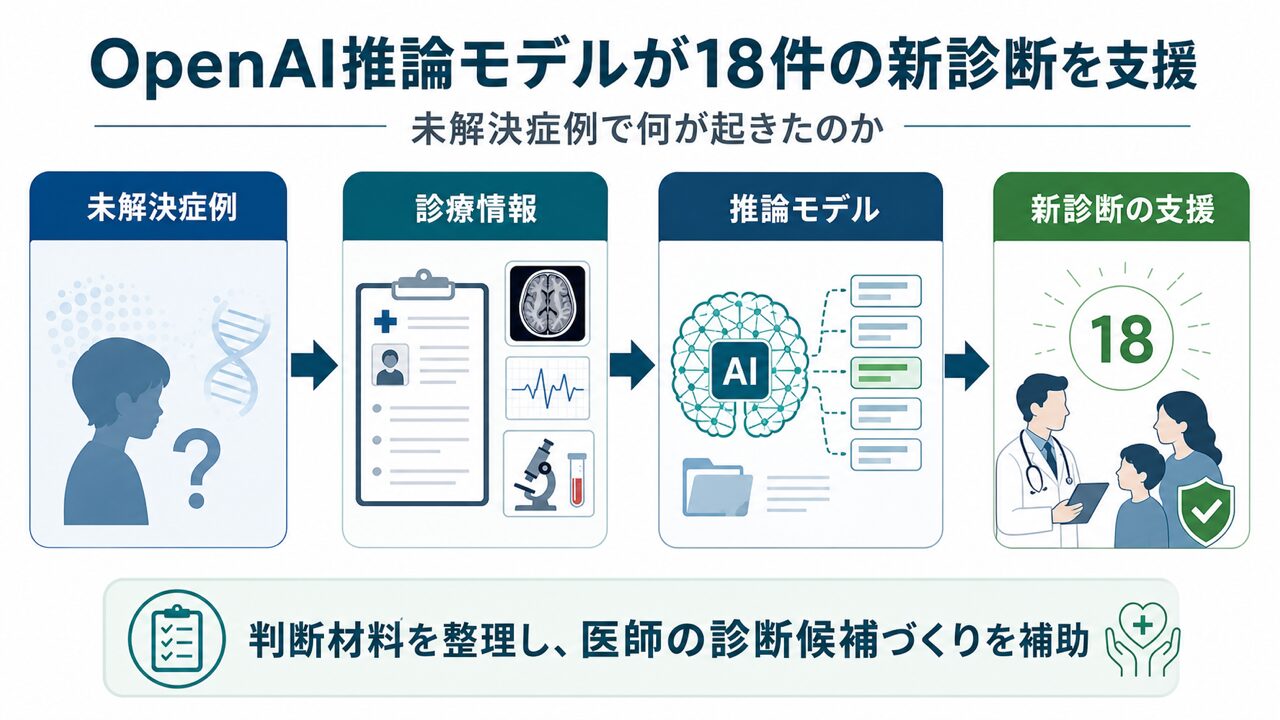
何が起きたのかを一言でいうと、過去に解析されて未解決だった小児376症例の記録を推論モデルで読み直し、専門家が確かめた結果、18症例で診断が確定した、ということです。図は全体の流れを模式的に示したもので、研究が実際にモデルへ渡した資料の中身は次の節で説明します(OpenAI公式発表)。
研究の概要
公式発表に書かれている研究の基本情報を、次の表にまとめます。
| 項目 | 公式発表の記載 |
|---|---|
| 公開日 | 2026年6月18日(NEJM AIにも同日掲載と記載) |
| 研究者 | Boston Children’s HospitalのManton Center for Orphan Disease Research、Harvard University、OpenAIの研究者 |
| 対象 | 過去に解析されながら未解決だった376症例(匿名化された臨床情報とゲノム情報) |
| 使用したモデル | OpenAI o3 Deep Research(リーズニングモデル) |
| 結果 | 専門家レビュー、追加検査、臨床的確認を経て18症例で診断を確定(診断率4.8%の上乗せ) |
| モデルの位置づけ | 患者の診断や臨床判断は行わず、根拠に結びついた仮説を生成 |
表の内容はすべてOpenAI公式発表の記載に沿っています。ここで押さえておきたいのは、使われたのがOpenAI o3 Deep Researchという研究用の利用であり、公式発表が、診断を目的としたOpenAI製品の顧客利用を説明したり推奨したりするものではないと述べている点です。
「18件の新診断」は何を数えた数字か
公式発表によると、所見が診断と認められる条件は次のとおりです。資格を持つ専門家が根拠をレビューしたこと、バリアント(遺伝子配列の違い)が病原性または病原性の可能性が高いと分類されたこと、CLIA認定検査室で確認されたこと、臨床チームが結果を家族に返したことです(OpenAI公式発表)。つまり「18件」は、モデルが候補を出した数ではなく、人間側の条件をすべて満たした症例の数です。
また、「新診断」という言葉にも注意が必要です。同じ公式発表は、18件の診断のうち7件は「再発見」だったと説明しています。現地の研究ワークフローの外ではすでに確定していたものの、チームがレビューした記録には含まれていなかった診断を指します。このため、18件がすべて世界で初めて見つかった診断というわけではありません。
研究の進め方:モデルに何を渡し、誰が確かめたか
この研究は、既存のゲノム解析パイプラインの上に、説明を第一にする推論レイヤーとしてモデルを置いた設計です。モデルに候補と根拠を出させ、その確認はすべて人間が行いました(OpenAI公式発表)。
モデルに渡した資料
各症例について、チームは匿名化された資料一式を作りました。公式発表によれば、含まれていたのは次のものです。
- 患者の臨床像を記述する標準化されたHuman Phenotype Ontology用語
- 場合により、臨床医のメモや記述的な臨床診断
- 年齢や性別などのメタデータ
- フィルタリング済みのバリアント表(各バリアントの希少性、コードされるタンパク質への予測される影響、ClinVar分類、利用可能な家族のシーケンスデータの信号品質)
ほとんどの症例には、子ども本人と両方の生物学的親のデータが含まれていました(OpenAI公式発表)。診察室のカルテや画像をそのまま入力したのではなく、研究用に整理・匿名化された資料だった点が、日常的なAIチャットの利用とは大きく異なります。
モデルに求めたこと
チームはモデルに、最も妥当な疾患を説明し得る最も妥当な分子遺伝学的原因を提案し、その根拠を示すよう求めました。順位付けされた遺伝子だけを返すのではなく、臨床的特徴、遺伝形式、バリアントの根拠、科学文献を結びつけ、人間のレビュアーが検証できる形の根拠づけを求めた、と公式発表は説明しています(OpenAI公式発表)。
「なぜその遺伝子が疑わしいのか」を人間が読んで確かめられることが、この設計の中心です。答えの当たり外れよりも、検証可能な説明が出るかどうかを重視した使い方だといえます。
人間によるレビュー
研究者は、臨床検査機関が遺伝的バリアントの分類に用いるものと同じACMG/AMPフレームワークでモデルの出力をレビューしました。各候補は少なくとも2人のチームメンバーが確認し、意見が分かれた場合は合意によって解決され、モデルの出力そのものが診断として扱われることはありませんでした(OpenAI公式発表)。
未解決症例の前に行った精度確認
未解決の症例を分析する前に、チームは診断がすでに確定している症例でワークフローを改良しました。公式発表が挙げている結果は次の表のとおりです。
| 確認用の症例セット | 公式発表に書かれた結果 |
|---|---|
| さまざまな希少疾患を含む51症例 | 48症例で、2回の独立した実行のいずれでも正しい遺伝子とバリアントを特定 |
| 神経筋疾患の57症例 | 45症例で、2回の独立した実行で正しい診断を返した |
| ロングリードゲノムの15症例 | すべての症例で正しい遺伝子を挙げ、12症例で疾患の原因となる2つのアレルを特定 |
公式発表によると、この確認はプロンプトの開発に役立ち、人間によるレビューがなお欠かせない領域を示す結果にもなりました。また、モデルが自己申告した信頼度スコアは、正しい診断と連動する傾向がありました。複数回の実行で一貫して正しかった判定の平均最小スコアは85.6、誤りまたは判定不能だったケースは42.1でした。ただし、このスコアは適切に調整・検証された確率値ではなく、根拠や臨床判断の代替としては使われていません(OpenAI公式発表)。
結果:376症例のうち18症例で診断を確定
確認用の症例で手順を整えたあと、研究チームは過去に未解決だった4つのグループにワークフローを適用し、376症例のうち18症例(4.8%)で診断を確定しました。これらは初回レビューを待つ新規症例ではなく、多くが複数の商用または機関内パイプラインで調べられ、多分野チームで議論されたものでした(OpenAI公式発表)。
| コホート | 症例数 | 診断につながった数 | 診断率 |
|---|---|---|---|
| 神経発達症のある子ども | 100 | 10 | 10.0% |
| 希少な神経筋疾患 | 61 | 4 | 6.6% |
| 小児における予期せぬ突然死 | 200 | 2 | 1.0% |
| 早発性精神病(小児と青年) | 15 | 2 | 13.3% |
| 合計 | 376 | 18 | 4.8% |
表の数値はOpenAI公式発表のコホート別結果によります。各行の数を足すと、症例数は376、診断数は18になります。
診断率4.8%をどう読むか
公式発表は、この4.8%を、割合としては控えめだが意味のある結果と位置づけています。理由は、対象が過去の専門家レビューで解決できなかった集団だからです。同様の再解析研究では、十分にレビューされた症例で1桁台の改善が報告されており、より高い診断率は通常、新規症例や遺伝学的確認待ちのよく知られた疾患を含む研究で得られる、と説明されています(OpenAI公式発表)。
読者として注意したいのは、この数字が「AIの正答率」ではないことです。4.8%は、376症例のうち、人間の確認手順を最後まで通過して診断が確定した割合です。比較の相手も他のAIではなく、すでに行われた専門家の解析です。
コホートによって診断率が違う理由
診断率は、神経発達症で10.0%、小児における予期せぬ突然死で1.0%と開きがあります。公式発表は、この差には各コホートで単一遺伝子による説明がどの程度見込まれるかも反映されていると説明しています。また、早発性精神病のコホートは15症例と小規模なため、その割合の信頼区間は広いとも述べています(OpenAI公式発表)。13.3%という数字だけを取り出して「精神疾患に強い」と読むのは適切ではありません。
18件のうち7件は再発見だった
公式発表によれば、18件の診断のうち7件は再発見でした。複数の症例で、バリアントはすでに公開データベースで病原性または病原性の可能性が高いと記載されていました。公式発表はこれを、データソースを横断して情報を統合することの運用上の難しさを示す例として紹介しています(OpenAI公式発表)。
これは、モデルの価値が「未知の病気の発見」だけでなく、「分散した記録と公開情報の突き合わせ」にもあり得ることを示します。一方で、この7件の存在は、18件を「AIが初めて見つけた診断」と呼べないことの根拠でもあります。
公式発表が挙げた具体例
公式発表は、モデルが示した手がかりの具体例として、入力に書かれていない構造変異の推定、2つの遺伝子による説明、診断までに約20年を要した症例などを紹介しています。いずれも専門家の確認を経たもの、または今後の検証が必要なものとして区別されています(OpenAI公式発表)。
入力に無かった構造変異を推定した例
早発性精神病のある1例で、モデルは入力データに記載されていなかったゲノム内の構造変異の存在を推定しました。22番染色体上で連続して見られた低品質なバリアントコールと、その子どもの心臓、免疫、神経発達、精神医学的特徴を結びつけ、DiGeorge症候群に関連する22q11.2欠失という仮説を立てました。この推定は、追跡のゲノムシーケンシングで確認されたと公式発表は述べています(OpenAI公式発表)。
2つの遺伝子で症状を説明した例
プロンプトでは単一遺伝子による原因を1つ求めていましたが、モデルは複雑な症状をよりよく説明する2つの遺伝子を示すことがありました。ある症例ではLAMA2とFOXP1のバリアントが筋肉と神経発達の特徴を合わせて説明する助けとなり、別の症例ではこれまで認識されていなかったTTNとSRPK3による説明が得られました(OpenAI公式発表)。
診断まで約20年かかった症例
公式発表の症例紹介には、9歳ごろに筋力の低下が気づかれ、診断のないまま検査や診察を重ねる約20年の道のりをたどった女性の例があります。この症例は神経筋コホートで確定した4件の1つで、チームはHSPB8のフレームシフトバリアントと結びつけ、筋原線維性ミオパチーの一種と診断しました。診断は、長い経過のなかで一定の区切りをもたらしたと紹介されています(OpenAI公式発表)。
診断以外に示された仮説と、検証が必要な点
公式発表は、診断に加えて検証可能な仮説も紹介しています。ある神経発達の症例で、モデルは尋常性白斑のある人に見られたS1PR1の11アミノ酸欠失に注目し、受容体の構造やシグナル伝達への影響を説明する根拠を統合しました。ただし、この関係には追加の実験的検証が必要だと明記されています。
神経筋コホートでは、HSPB8とCDK13の機能に有害な影響を及ぼす可能性のあるバリアントが、各遺伝子で最もよく知られる疾患とは完全には一致せず、臨床症状の幅がこれまで知られていたより広い可能性が示されました。これにも、より多くの症例と実験室での検証が必要とされています(OpenAI公式発表)。仮説の段階にある内容は、診断の成果と混同しないよう読み分けることが大切です。
なぜ古い症例に新しい答えが見つかるのか
遺伝子検査で結論が出なかった結果は、恒久的なものとは限りません。患者のゲノムが同じでも、その解釈に使える科学的根拠が時間とともに増えるため、再解析によって以前は見えなかった答えが現れることがあります(OpenAI公式発表)。
公式発表は、その理由をいくつか挙げています。1つ目は、データが分散していることです。患者の表現型の記述、検査結果、家族歴は、異なる識別子、形式、語彙を使う複数のデータベースに散らばっていることがあり、結びつけるのが難しく、専門家でも診断を見落とすことがあります。2つ目は、時間差です。専門家が子どものゲノムをシーケンシングした時点では、関連する遺伝子やバリアントと疾患との関連が明らかになっていない場合があります。
3つ目は、再解析が継続的な維持管理の課題だという点です。研究者は新しい遺伝子やバリアントを疾患に結びつけ、検査機関は古いバリアントを再分類し、症例データベースや論文には新たな観察結果が蓄積されます。更新のたびに過去の未解決症例を見直す価値が生まれるため、多くの機関で、変化し続ける知識基盤と同期させるべきゲノムのバックログが生じます(OpenAI公式発表)。
この背景を踏まえると、研究の意味は「AIが専門家より賢い」ことではなく、膨大で更新され続ける情報を読み直す作業を、専門家が扱える形に絞り込む手伝いができるかもしれない、という点にあります。公式発表も、専門家主導の定期的な再解析をより拡張可能にできる可能性が示唆される、という表現にとどめています。
モデルと人間の役割分担
この研究では、モデルが担ったのは根拠つきの仮説づくりまでで、診断の確定と家族への返却は人間が担いました。両者の役割を分けて読むことが、18件という数字を正しく受け取る前提になります(OpenAI公式発表)。
| 工程 | OpenAI o3 Deep Research | 研究者・臨床の専門家 |
|---|---|---|
| 資料の準備 | 担当しない(渡された匿名化資料を読む) | 標準化された表現型用語、メタデータ、フィルタリング済みバリアント表などを作成 |
| 候補の提示 | 最も妥当な分子遺伝学的原因と、その根拠を提示 | 求める出力の形(根拠づけを含む説明)を設計 |
| 候補の評価 | モデルの出力そのものは診断として扱われない | ACMG/AMPフレームワークで、各候補を少なくとも2人が確認 |
| 診断としての確定 | 診断や臨床判断は行わない | 資格を持つ専門家のレビューと、CLIA認定検査室での確認 |
| 家族への返却 | どの情報や診断を返すかは決めていない | 臨床チームが結果を家族に返す |
表の内容はOpenAI公式発表の記載を工程ごとに並べ直したものです。モデルは探索範囲を広げ、その後の人間主導の分析の焦点を絞りましたが、診断や家族への返却の判断は人間が担った、と公式発表は述べています。
公式発表が示す限界
公式発表は、この研究が患者、臨床医、顧客がOpenAIのモデルを疾患の診断や医療判断に使うべきことを示す根拠ではない、と明確に述べています。研究の限界も本文中で具体的に挙げられています(OpenAI公式発表)。
- 既存の症例データを分析した研究で、コホートは不均一でした。
- レビュアーには、モデルの信頼度が開示されていました。
- 短縮された時間、費用、臨床医の負担、偽陽性への対応量、ケアの変化は測定されていません。
- 構造バリアント、反復配列伸長、深部イントロン変化、モザイクなど、他の形態の遺伝的変異は、体系的には評価されていません。
- 大規模言語モデルは文脈を読み違えたり、詳しく調べると成り立たないもっともらしい説明を生成したりすることがあります。
- モデルへのアクセスは、シーケンシング基盤、遺伝カウンセリング、確認検査、専門家の判断に取って代わるものではありません。
上記はOpenAI公式発表の「限界」の記載にもとづきます。プライバシーについても、本研究は匿名化された情報を使い、保護対象の健康情報は承認済み環境の外で利用・送信されなかったと説明されています。より広い臨床導入には、すべての医療に適用されるプライバシー、セキュリティ、監査可能性、地域規制への配慮が必要だと明記されています。
読者別の受け止め方
この研究は、診断に使えるAIが登場したという話ではなく、専門家が過去の未解決症例を見直す作業をAIが手伝える可能性を示した、研究段階の成果です。読者の立場ごとに、受け止め方は次のように変わります。
患者・家族の方へ
診断のつかない状態が続いている場合でも、この研究を根拠にチャットAIへ症状やゲノム情報を入力して診断を試みることは、公式発表が推奨している使い方ではありません。公式発表の記載では、すべての診断は、確立されたレビュー、検査、臨床的確認の手順を経て確定しています。気になる点は、主治医や専門の医療機関に相談し、再解析や追加検査が可能かを確認するのが現実的な窓口です。個人の健康情報や遺伝情報を、安全性が確認されていないサービスへ入力することにも注意してください。
医療者・研究者の方へ
公式発表は、再現性と安全性のために、バージョン管理されたプロンプト、参照の確認、監査ログ、不確実性の適切な評価と調整が重要になると述べています。信頼度スコアが調整された確率値ではなかったことも、再現や比較を行う際の前提として確認しておく必要があります。
AIを仕事で使う方へ
医療に限らず、この研究から持ち帰れる考え方は、AIの出力を「結論」ではなく「検証できる根拠つきの仮説」として扱う設計です。出力に根拠を求め、人間が確かめる工程を決め、確認を通過したものだけを成果として数える。この区別は、機密性の高い情報を扱う業務でも応用できます。ただし、診断や法的判断のように結果が重大な領域では、専門家の確認を省かないことが前提です。
今後の研究と公式発表が述べる展望
公式発表が今後の課題として挙げているのは、LLM支援による再解析と標準的な実務を比較する前向きの多施設研究です。診断率、候補に到達するまでの時間、臨床医の負担、偽陽性の負担、コスト、診療への影響を評価すべきだとしています(OpenAI公式発表)。
この初期研究はOpenAIが支援しましたが、次の段階はOpenAI Foundationからの助成金を通じてManton Centerが主導します。助成金は、臨床チームが希少疾患の症例をより迅速かつ一貫して分析できるようにする、プラットフォーム非依存で低コストの遺伝学AIコパイロットの開発を支援するものです。
公式発表は、本研究でOpenAI o3 Deep Researchを使ったことに触れたうえで、新しい汎用モデルはより多くの科学文献を検索して統合できる一方、目的特化型のシステムはライフサイエンス領域のより深い作業を想定しているとも述べています。ただし、これらの機能は本研究では検証されておらず、別途の評価とアクセス制御が必要だとされています。モデルの世代が変わっても同じ結果が得られるとは限らない点に注意してください。
ライフサイエンス領域でのAI評価の動きについては、OpenAIのライフサイエンスAI評価をまとめた記事もあわせて参考になります。
よくある質問
- Q1. 「18件」は18人の患者のことですか?
-
公式発表の表現は「18症例」です。376症例のうち、専門家の確認手順をすべて通過して診断が確定した症例の数を指します。診断が確定した症例のうち7件は再発見だったため、18件すべてが新規の発見というわけではありません(OpenAI公式発表)。
- Q2. AIが病気を診断したのですか?
-
いいえ。公式発表の記載では、モデルは参加者を診断しておらず、すべての診断は、医師などの資格を持つ臨床の担い手が、確立されたレビュー、検査、臨床的確認の手順で行いました。モデルは、専門家が確かめられる根拠つきの仮説を生成しました(OpenAI公式発表)。
- Q3. 診断率4.8%は高いのですか、低いのですか?
-
公式発表は、割合としては控えめだが意味のある結果と位置づけています。対象が過去の専門家レビューで解決できなかった集団であり、同様の再解析研究では十分にレビューされた症例で1桁台の改善が報告されているためです。他のAIとの比較ではなく、従来の専門家解析に上乗せされた割合である点に注意してください(OpenAI公式発表)。
- Q4. ChatGPTに症状を入力すれば、同じように診断のヒントが得られますか?
-
この研究は、その使い方を支持する根拠ではありません。公式発表は、患者、臨床医、顧客がOpenAIのモデルを疾患の診断や医療判断に使うべきことを示すものではなく、診断目的での顧客利用を説明したり推奨したりするものでもないと述べています。研究では、匿名化され整理された資料と、専門家による多段階の確認がセットでした(OpenAI公式発表)。
- Q5. 使われたOpenAI o3 Deep Researchは、今のChatGPTで使えますか?
-
公式発表のこのページは、研究で使ったモデルの名前を記載していますが、現在の各製品での提供状況や利用条件については説明していません。提供状況は各製品の公式ページで確認してください。いずれの場合も、公式発表は診断目的での利用を推奨していません(OpenAI公式発表)。
- Q6. 日本の病院でも同じ研究ができますか?
-
この公式発表は、Boston Children’s Hospitalなどの研究者が行った研究を紹介するもので、日本の医療機関での実施可否や国内の規制については説明していません。公式発表は一般論として、より広い臨床導入には、すべての医療に適用されるプライバシー、セキュリティ、監査可能性、地域規制への配慮が必要だと述べています(OpenAI公式発表)。
- Q7. 診断がつかないままの場合、どうすればよいですか?
-
公式発表は、知識が進展した後や、分断された記録が統合された後に初めて見えてくる答えがあることを、定期的な再解析が重要な理由として挙げています。ご自身の場合に再解析や追加検査が可能かどうかは、主治医や専門の医療機関に相談して確認してください。この記事は一般的な情報の整理であり、個別の診断や治療の助言ではありません(OpenAI公式発表)。
- Q8. 医療以外の仕事にも、この研究の考え方は参考になりますか?
-
AIの出力を結論として扱わず、根拠つきの仮説として受け取り、人間が確認した結果だけを成果として数える、という設計は参考になります。公式発表も、再現性と安全性のために、バージョン管理されたプロンプト、参照の確認、監査ログが重要になると述べています。ただし、結果が重大な領域では専門家の確認が前提です(OpenAI公式発表)。
用語集
| 用語 | 説明 |
|---|---|
| 再解析 | 過去に解析されて結論が出なかった症例のデータを、新しい科学的根拠や整理された記録をもとに見直すこと。 |
| リーズニングモデル | OpenAIが公式発表で、本研究に使ったOpenAI o3 Deep Researchを指して用いている呼び方。 |
| Human Phenotype Ontology(HPO) | 患者の臨床像を標準化された用語で記述するための語彙。本研究では、各症例の臨床像の記述に用いられた。 |
| バリアント | ゲノムの配列に見られる個人間の違い。病気に関わるものと関わらないものがある。 |
| ClinVar | バリアントの臨床的な分類が登録されている公開データベース。本研究ではバリアント表の項目として使われた。 |
| ACMG/AMPフレームワーク | 臨床検査機関が遺伝的バリアントの分類に用いる枠組み。本研究では、モデル出力のレビューに使われた。 |
| CLIA認定検査室 | 米国の臨床検査室の認証制度(CLIA)の認定を受けた検査室。本研究では、診断として数える条件の1つにCLIA認定検査室での確認が含まれた。 |
| 診断率の上乗せ | 専門家による従来の解析のあとに、追加で診断に至った症例の割合。本研究では4.8%。 |
| 再発見 | 現地の研究ワークフロー外ではすでに確定していたが、チームがレビューした記録には含まれていなかった診断。本研究の18件のうち7件。 |
まとめ
OpenAIの公式発表によると、Boston Children’s Hospital、Harvard University、OpenAIの研究者は、過去に未解決だった小児376症例をOpenAI o3 Deep Researchで再解析し、専門家の確認を経て18症例(4.8%)で診断を確定しました。モデルが示したのは根拠つきの仮説で、診断の確定は、ACMG/AMPフレームワークによるレビュー、CLIA認定検査室での確認、臨床チームによる家族への返却という人間側の手順を通過した症例に限られます(OpenAI公式発表)。
読むときの要点は3つです。第一に、18件のうち7件は再発見であり、すべてが初めて見つかった診断ではないこと。第二に、時間、費用、臨床医の負担、偽陽性への対応量、ケアの変化は測定されていないこと。第三に、公式発表自身が、診断や医療判断へのOpenAIモデルの利用を示す根拠ではないと述べていることです。研究段階の成果として、専門家が過去の未解決症例を見直す作業をAIが手伝える可能性を示した内容、と受け止めるのが妥当です。
AI×SNSで「普通の人」が成果を出す方法を、無料で体系的に学べます
ChatGPTやOpenAIのAIを仕事に取り入れ、SNS運用・集客・ビジネス自動化に応用したい方は、まず無料特典から始めてみてください。
※本記事は、2026年6月18日付のOpenAI公式発表を2026年10月11日に確認した内容にもとづく一般的な情報提供です。医療上の判断や診断、治療の助言を目的とするものではありません。気になる症状や診断については、医師などの専門家にご相談ください。公式発表の内容や各製品の提供状況は変更される場合があるため、最新の状況はOpenAI公式でご確認ください。
次に読みたい関連記事
このテーマの全体像: ChatGPTを初心者から使いこなすまでの手順
あわせて読みたい・姉妹メディア